从“凭经验”到“看数据”:学情分析如何真正反哺备课与课堂决策!
以往备课,教师多凭经验判断教学重难点、预估学生卡点。经验虽有价值,却不够精准,很难定位到具体知识点和学生问题。
智慧教学带来的转变,是让数据与经验结合。课前正确率、知识图谱、错题聚类,能把模糊判断做实:经验能大致判断哪块内容难学,数据则能看清是谁、卡在哪个知识点。
本文介绍三类常用学情数据,讲清如何用来优化备课与课堂决策。
' fill='%23FFFFFF'%3E%3Crect x='249' y='126' width='1' height='1'%3E%3C/rect%3E%3C/g%3E%3C/g%3E%3C/svg%3E)
一、正确率分布:回答"整体掌握到什么程度"
正确率分布是最基础也最直接的学情数据。一次课前预习测试或课堂随测之后,系统会呈现每道题、每个知识点的正确率。但它的价值不在于"看一个数字",而在于通过分布形态判断教学起点。
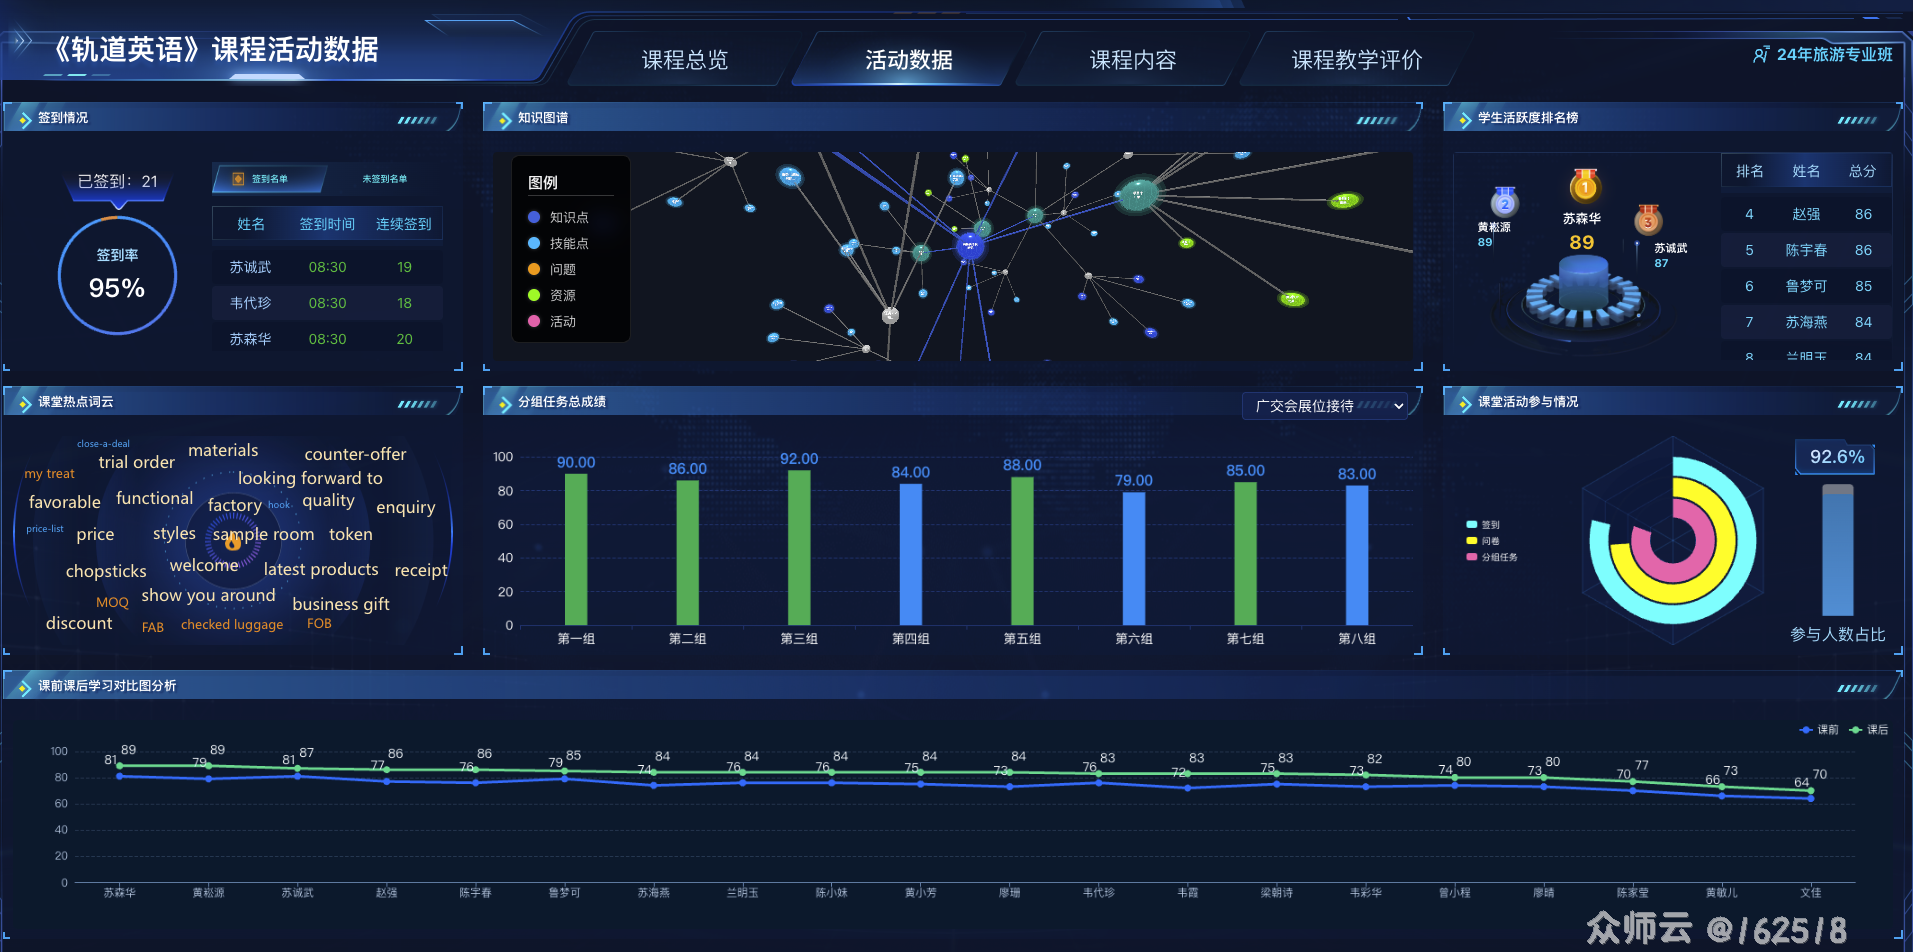
反哺备课的三种用法:
定位教学起点。 如果某知识点的课前测试正确率普遍在80%以上,说明多数学生已具备基础,课堂不必从零讲起,可以把时间留给深化应用和易错辨析;若正确率低于50%,说明前置知识缺口较大,需要先补足前置内容,再进入新知。
识别"假性掌握"。 正确率高不一定代表真懂。如果一道题正确率很高但耗时异常长,或者同知识点在变式题上正确率骤降,说明学生可能只是记住了套路。备课时就应有意识地设计变式训练和追问,而不是被表面的高正确率"骗"过去。
确定讲评优先级。 一节课时间有限,不可能每道题都讲。正确率分布可以帮助教师快速排序:正确率低且涉及核心概念的题优先讲,正确率低但属于边缘细节的题可以做成课后资源包,正确率高的题略讲或让学生互讲。
课堂决策上的应用: 课堂随测的正确率分布可以实时呈现在教师端。教师向学生端推送随堂习题、课堂小测后,可实时查看答题进度与当堂正确率,"讲到哪卡住当场看得见,是否重讲不必等批改作业"。教师据此当场决定"这道题要不要展开""是集体讲评还是小组互助",实现动态调整教学策略。
二、知识图谱:支撑教案中的"分层设计"与课堂实录中的"差异化实施"
知识图谱回答"知识点之间是什么关系"——前置、后续、包含、关联,是一张结构化的知识网络。把它和各节点的掌握状态叠加起来,教师看到的就不是孤立的正确率数字,而是一张带状态标记的知识网络:哪个节点薄弱、它的前置节点是否也已经薄弱、补这个节点还是先补前置。这也是知识图谱在比赛中最有价值的用法——它让"分层教学"从口号变成可见的设计。
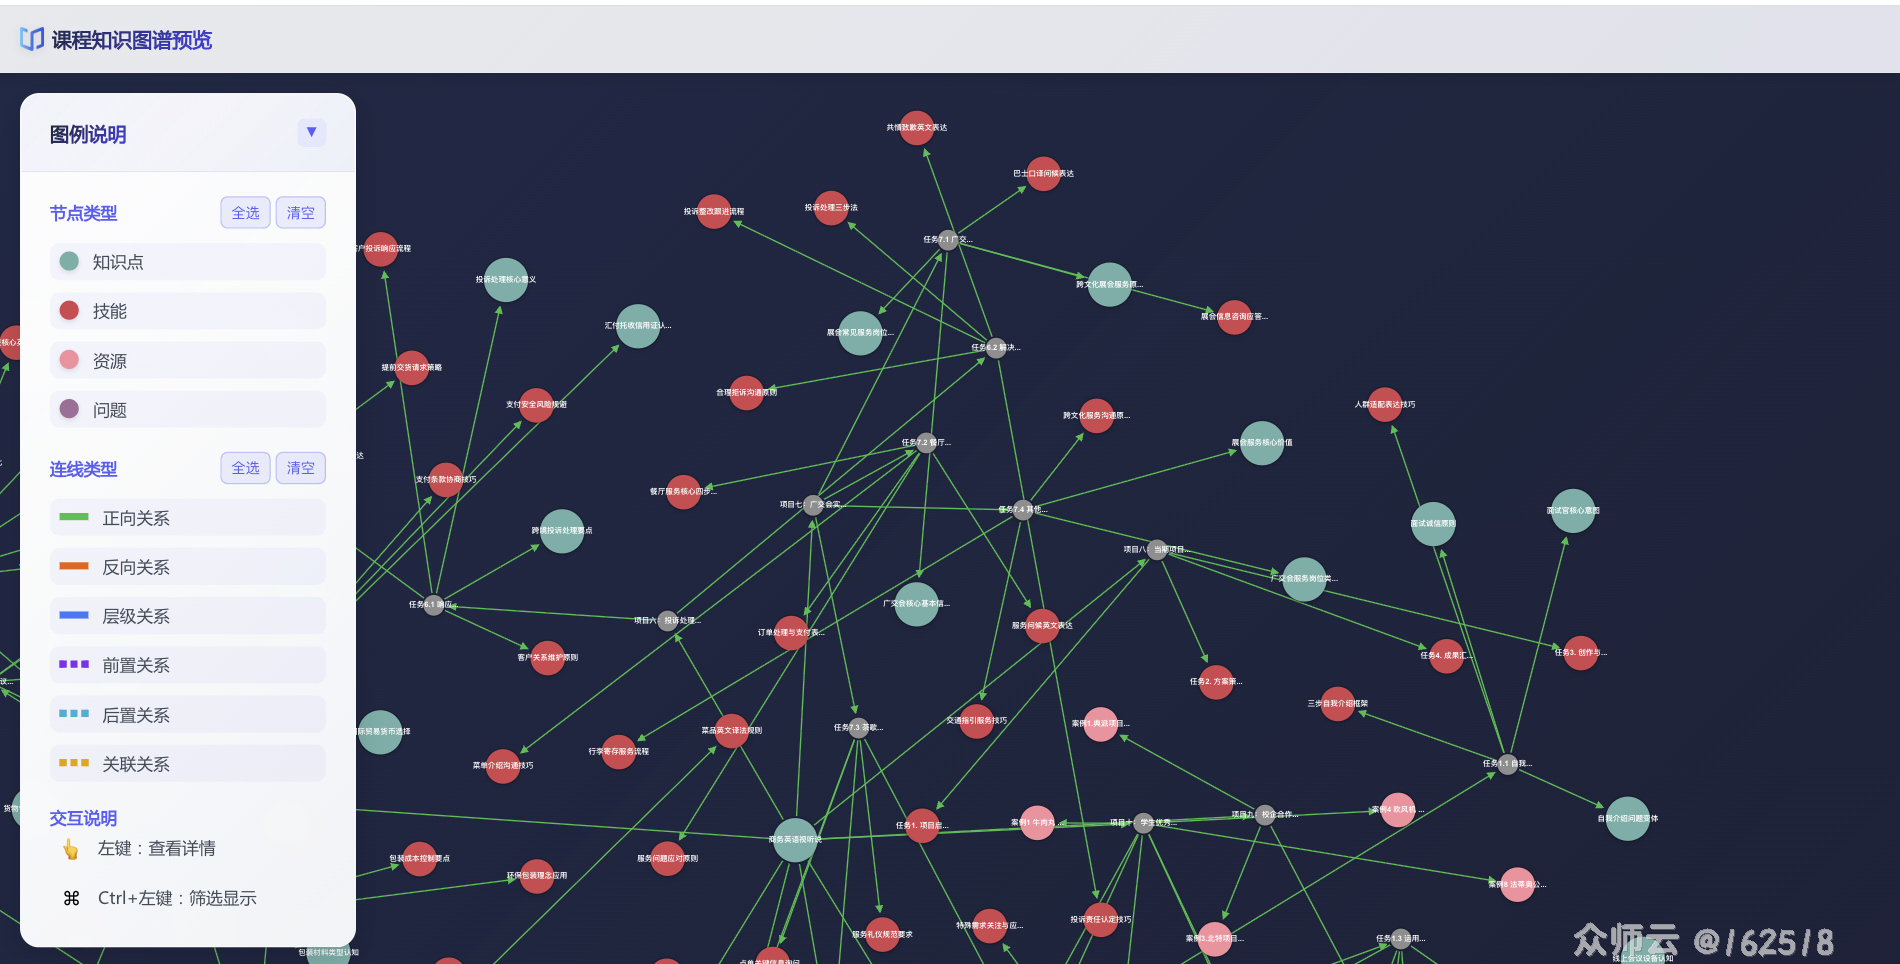
反哺备课的核心价值:
在教案层面,知识图谱支撑两个关键设计。
一是分层任务设计:教案中呈现图谱上的红黄绿节点分布,据此说明基础层先补前置节点再做巩固练习、进阶层做拓展项目、教师精力集中于薄弱节点学生,分层逻辑清晰可查;更重要的是,能顺着图谱的前置关系判断薄弱来源——某节点薄弱,若其前置节点同样薄弱,就先补前置而不是硬讲本节点。
二是互补型分组设计:协作环节的分组不是按座位随机,而是依据图谱做红黄绿搭配,优先让前置节点掌握较好的学生带动前置薄弱的学生,教案中写明分组依据,评委就能看出这不是形式上的"小组合作",而是有数据支撑的教学组织。
在课堂实录层面,知识图谱的价值在于"让数据成为课堂讨论的对象"。教师将班级知识图谱一键投屏,学生看到的不仅是PPT,还有自己班级在知识网络上的位置和掌握状态,课堂讨论有了具体对象。实录中呈现这一环节,能直观展示"数据如何进入课堂、如何激发学生元认知",这是教学比赛中区分"真智慧课堂"与"表演型课堂"的关键细节。
在教学创新成果报告和答辩中,知识图谱还能支撑"差异化教学成效"的论证。对比课前与课后的图谱状态变化,薄弱节点减少、掌握节点扩大,用可视化证据说明分层教学的实际效果,比文字描述有力得多。
三、错题聚类:回答"错在哪里、为什么错"
错题聚类进一步回答"错的性质是什么"。通过对错题进行聚类分析,可以把零散的错误归并为几类典型问题:是概念理解偏差、是计算粗心、是审题不清,还是知识迁移失败。
反哺备课的关键作用:
让讲评从"对答案"升级为"治病因"。 备课时,教师依据错题聚类结果,可以针对每一类错误设计不同的教学干预:概念性错误需要重新讲解和对比辨析,程序性错误需要示范规范步骤,审题性错误需要专项训练。
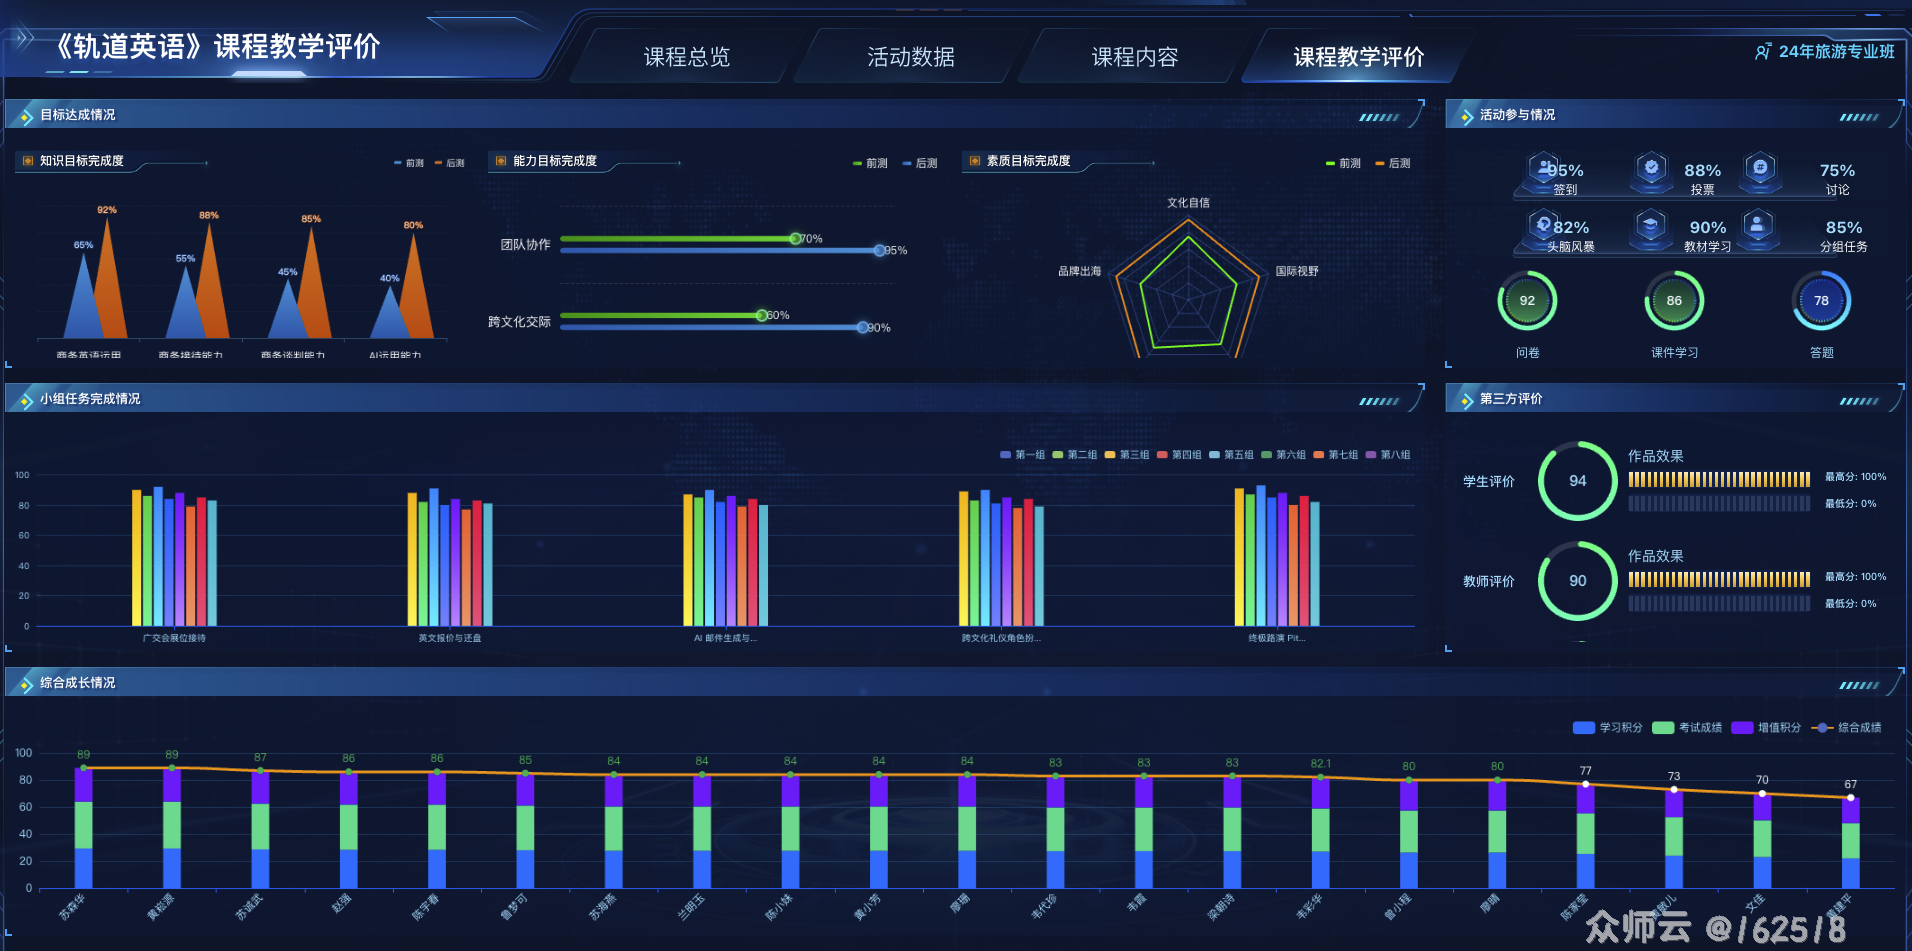
发现教学设计本身的问题。 错题聚类最有价值的信号之一,是"全班在某类错误上高度集中"。如果某个知识点全班正确率都很低,且错误类型高度一致,那往往不是学生的问题,而是教学设计需要调整——可能是讲解方式不适合,可能是例题梯度不合理。这种"数据反哺"机制,正是智慧课程形成闭环的关键一环。错题聚类也不是孤立的:学情分析还看知识点正确率、课堂学习行为、预习反馈三个维度,四维评价同步学生档案与成长看板,教学质量诊断则把课堂活动效果、备课资源使用率等纳入进来,让分析从学生维度延伸到教学维度。
课堂决策上的应用: 错题聚类结果可以转化为课堂上的"典型错误展示"环节。把几类典型错题匿名呈现,让学生辨析"错在哪、为什么错、怎么改",比教师直接讲正确答案更能激活元认知。同时,聚类结果也是课后个性化作业自动生成的依据——按薄弱知识点再生成一组练习与讲解要点,直接推给对应学生,不同错误类型的学生收到不同侧重的巩固练习。
四、三类数据的协同:从"看数据"到"用数据决策"
需要强调的是,正确率分布、知识图谱、错题聚类并非孤立使用,而是构成一个从"面"到"点"、从"结果"到"原因"的诊断链条:正确率分布判断整体掌握水平,知识图谱定位具体知识点和学生群体,错题聚类剖析错误性质。三者结合,才能支撑起真正的数据驱动精准教学。
数据反哺要真正落地,有两个关键前提:
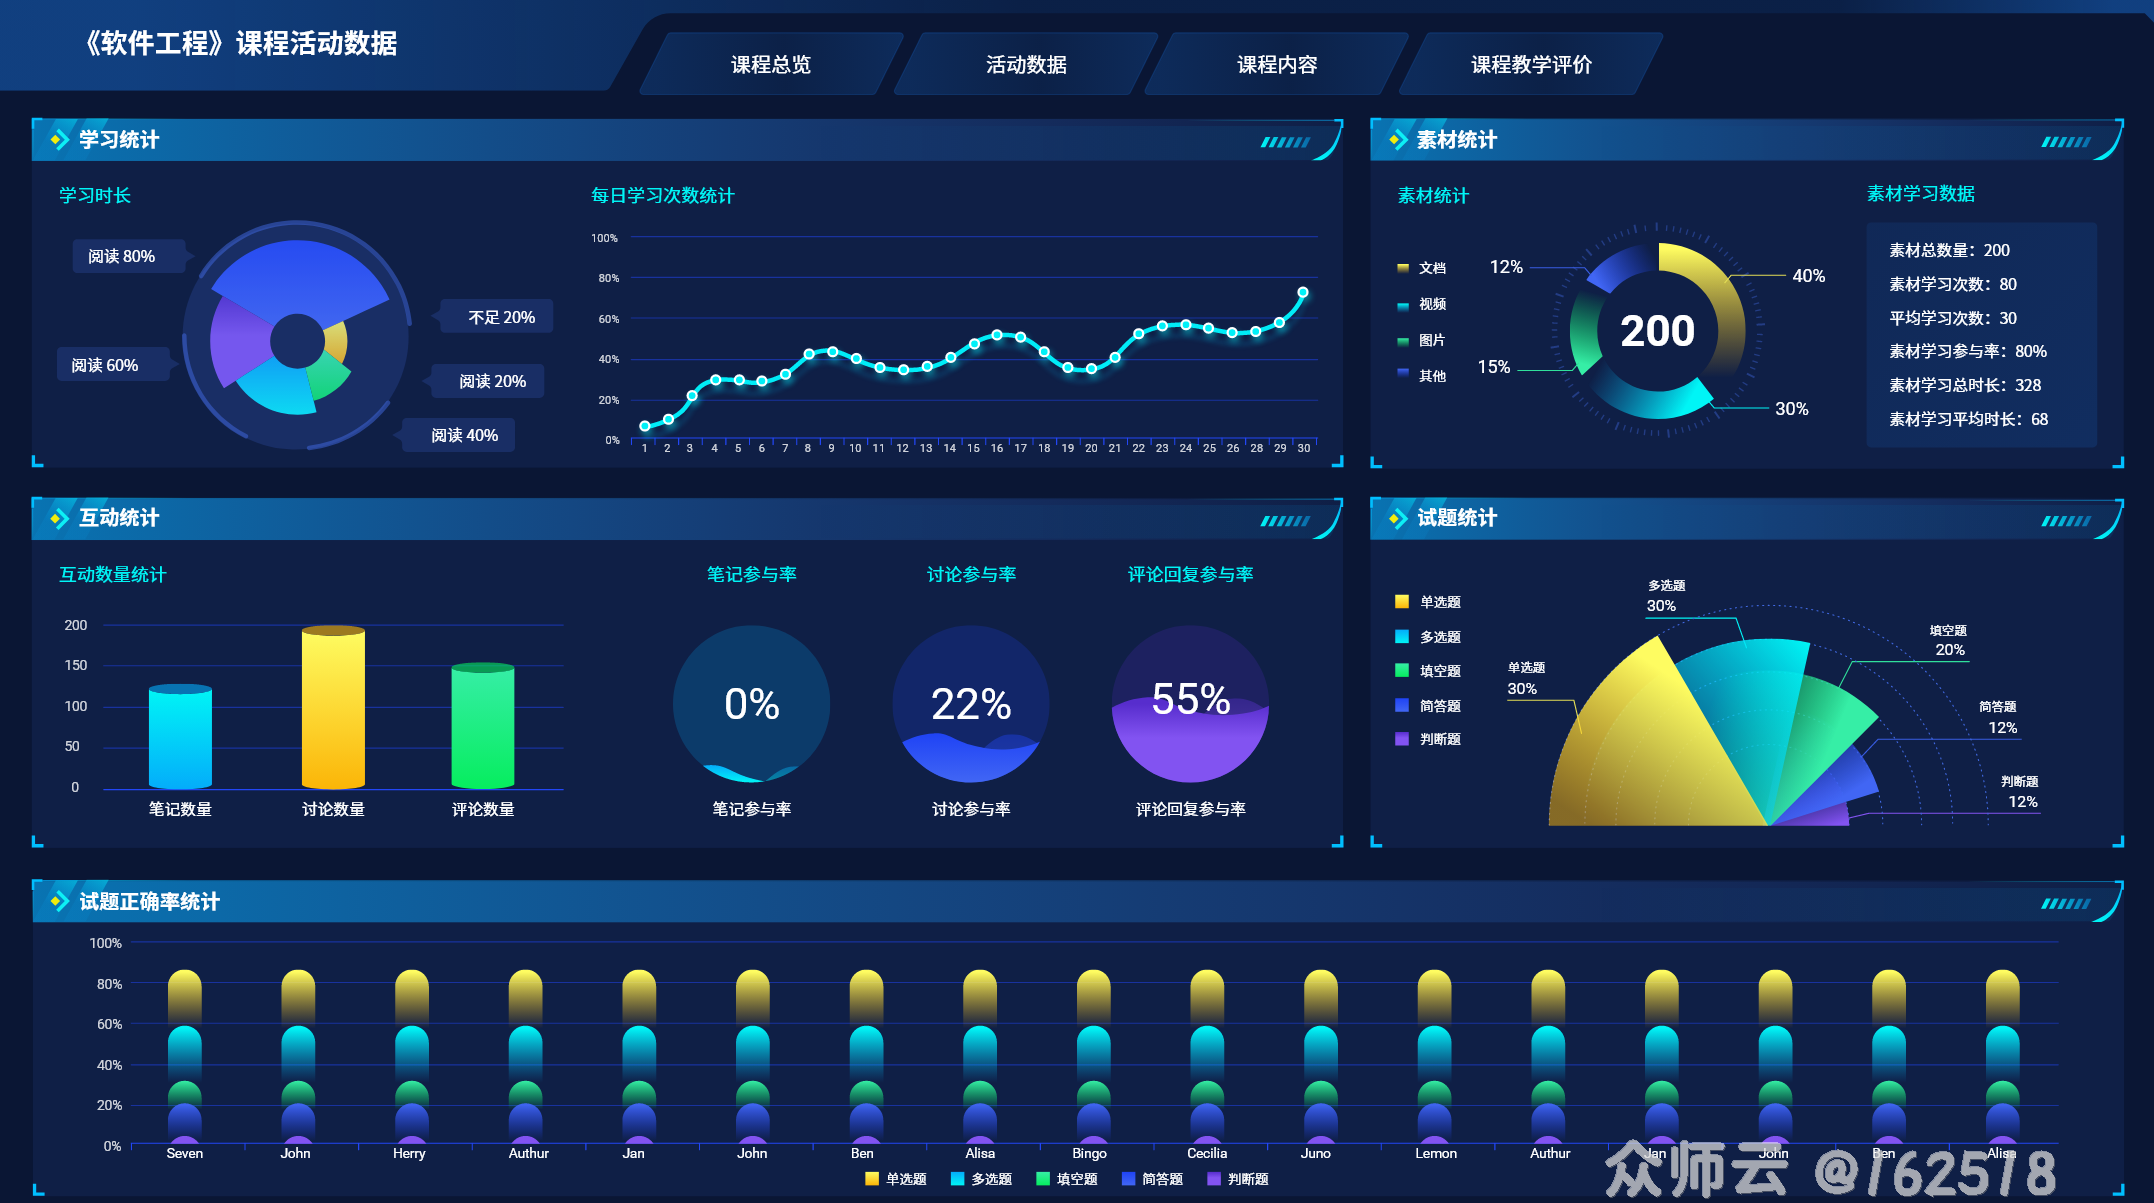
一是数据采集要自动化、常态化。 课前打开数据大屏看上一单元学情,定这节课的侧重点——哪个知识点正确率低、哪几个学生连续没交作业,开课前就知道;课后大屏自动生成报表,看预警中心定位薄弱点,用AI生成补差习题与个性化评价。数据在教材、题库、备课区、课堂之间自动流转,不必再手动从文档往题库里搬,教师才能持续用下去。
二是教师要具备数据解读能力。 教师培训不能只教设备操作,更要帮助教师理解数据驱动教学的逻辑——培训的重点不是看板怎么点,而是"数据说明什么、我该做什么"。
衡量智慧课程建设,最终要看这门课的教学改进是否真正形成了闭环。
用好学情数据,核心思路是把数据嵌入备课、课堂全流程,用数据补足经验。借助正确率分布确定授课内容,依靠知识图谱上知识点节点的掌握状态来间接定位需要关注的学生,通过错题聚类调整讲解方式。备课时调取过往学情确定教学起点,课上依托实时数据动态调整节奏,课后依据错因推送分层巩固任务。数据与教师经验互为补充。坚持常态化采集、读懂数据背后的学习问题,精准教学就能落地。


